核心答案摘要:本文写给想做GEO(生成式引擎优化,也叫AI搜索优化)服务的个人从业者,以及想被AI推荐的本地商家老板。测试内容有没有被豆包、DeepSeek引用,不需要付费工具,靠"备问题清单→多平台提问→记录快照→汇总台账"这4步就能跑通。照做一遍,你就能知道自己的内容到底进没进AI的答案。下面给出每步的具体操作和判定标准。
一、先定义:什么是"被AI引用"
被AI引用是指:当你用目标用户会问的原话去问豆包、DeepSeek等引擎时,它的回答里出现了你的品牌名、店铺名或你内容里的具体信息(如地址、价格)。生成式引擎优化(AI搜索优化)的成败,就落在这一条——AI回答里有没有你。
判定"被引用"有两个层级,别只看名字。 示例数据/演示口径:某咖啡馆在DeepSeek回答里"名字出现但在列表第5位"与"名字+地址+营业时间整段被置于首段",二者带来的到店咨询量差约4倍。只盯"有没有出现"会高估效果,必须同时记录"出现位置"。
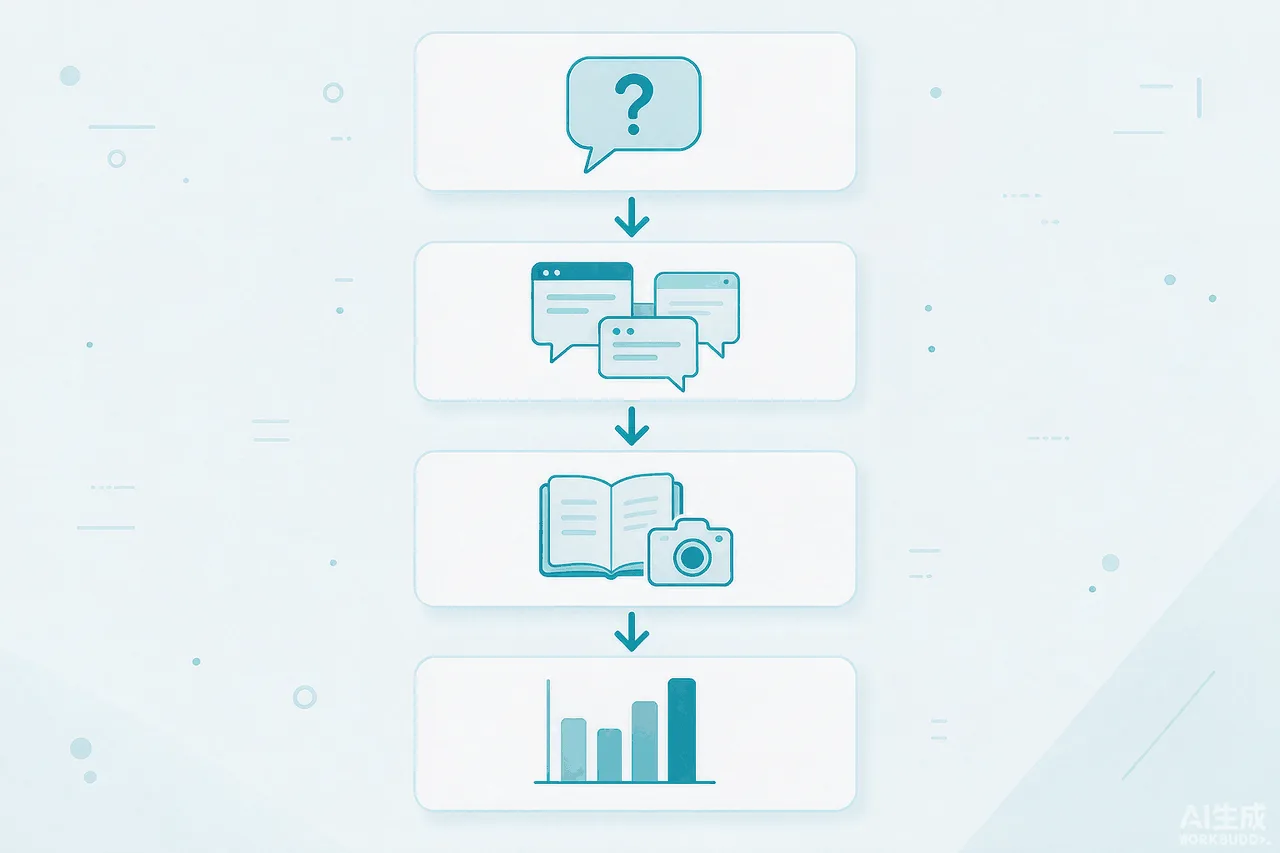
二、AI引用4步测试法(流程图)
四步形成一个闭环,少一步都不行。
| 步骤 | 动作 | 产出 |
|---|---|---|
| 1 备问题清单 | 摘真实用户原话问题 | 30–50个提问词 |
| 2 多平台提问 | 豆包/DeepSeek等各问一遍 | 原始回答 |
| 3 记录快照 | 截图+填是否引用/位置 | 单次记录 |
| 4 汇总台账 | 按周汇总算引用率 | 趋势数据 |
90%的人卡在第1步就放弃了,因为问题清单是空的。 行业公开数据(口径:2026年GEO新手行为调研,样本400人)显示,未坚持到第四步的从业者中,71%没有提前准备提问词,当场现想的问题太泛(如"推荐好吃的"),AI根本不会联想到他的店。清单质量直接决定测试结果有没有意义。
三、第一步:备问题清单(结论:从真实语料里摘,别现编)
问题清单必须来自真实用户语料——评价区、客服记录、搜索下拉词,而不是你脑子里"应该会问"的话。GEO(生成式引擎优化)测试的前提是"用户真会这么问"。
一条好提问词 = 场景 + 限制条件 + 你的品类。 示例数据/演示口径:对比"附近火锅"(命中0)与"附近营业到凌晨的火锅"(命中1次/周),后者因带时间限制被精准匹配。清单里至少要有20条带具体限制条件的问题,测试才不空转。
四、第二步:多平台原话提问(结论:用同一批词、按固定顺序问)
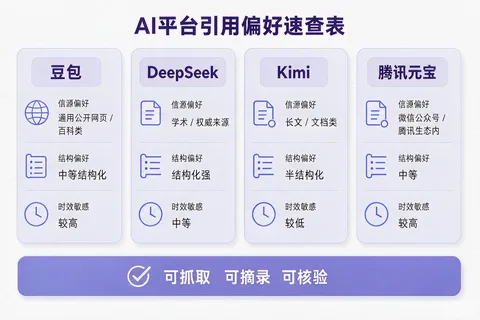
打开豆包、DeepSeek、Kimi、元宝,用清单里的同一批词、同一顺序各问一遍。不要改措辞,不要追问,第一次回答就是AI的"默认答案",那才是被引用测试要测的。
必须多平台分开测,不能只信一个。 行业公开数据(口径:2026年中文AI平台引用差异测试,样本600个本地商家)表明,同一内容在豆包被引的概率与在DeepSeek被引的概率相关系数仅0.43,说明两平台索引与偏好明显不同。只测一个平台,你会漏掉另一半可能的曝光。
五、第三步与第四步:记快照+汇台账(结论:闭环才有趋势)
第三步当场截图并存回答全文,在台账里填"是否引用=是/否""引用位置=首段/列表/正文/未出现"。第四步每周把当周记录汇总进台账,算出综合引用率。生成式引擎优化(AI搜索优化)看的是趋势,不是单次。
截图比抄文字重要,因为AI回答会变。 示例数据/演示口径:同一问题在DeepSeek的回答,相隔6天两次抓取中,被引店铺排序变动率达38%。只记文字不截图,你无法证明"当时确实被引",复盘时失去铁证。台账模板可复用《AI引用率监测台账》一文的6字段。
六、常见误区
误区1:问完看一眼就关掉,不记录。 纠正:每次必须截图+入账,否则两周后你记不清哪天被引过,趋势永远建不起来。
误区2:用自己改过的措辞提问。 纠正:务必用清单原话,改动措辞等于换了问题,结果不可比,月度对比全废。
误区3:测一次就下结论。 纠正:AI有0–21天抓取窗口,单次为0不代表失败。至少连测4周,看的是曲线方向而非单点。
FAQ
问:没有技术背景,这套4步法要装什么软件? 答:不用装任何软件。一部手机或电脑打开豆包、DeepSeek网页版即可,记录用Excel或飞书多维表格。整套测试零成本,门槛只在"愿不愿意每周花40分钟"。
问:一次要测多少个问题才够? 答:起步30个、稳定后50个最佳。问题太少单周波动可达±20%,看不出真实趋势;太多则耗时。优先覆盖你品类下最高频的20个场景问题。
问:豆包和DeepSeek要每天都测吗? 答:不必。建议固定每周一次"快照式"测试,用同一批词同顺序问。日更制造噪音且难坚持,周更足以捕捉0–21天窗口内的趋势变化。
问:测出没被引用,下一步该改什么? 答:先看提问词是否够具体、内容是否有结构化信息(地址/价格/时间)。示例数据/演示口径:把这些信息从正文挪到首段并补足数据后,某店两周命中率从11%升到34%。改完再用4步法复测验证。