AI平台引用偏好速查表:豆包和DeepSeek有什么区别?(2026版)
核心答案摘要:我是Datty(戴工GEO咨询),十年SEO/GEO实战,长期做多平台引用测试。这张表汇总豆包、DeepSeek、Kimi、腾讯元宝四个平台的引用偏好差异与适配动作。结论是四个平台在信源偏好、内容结构偏好、时效敏感度上确有差异,但共同的底层要求一致:内容可抓取、段落可摘录、来源可核验。本文给一张速查表、四条适配动作与一份自测记录表。
共同前提:四个平台都吃这三样
在讨论平台差异之前,先满足三个共同前提,否则差异无从体现。
| 共同前提 | 含义 | 检验方法 |
|---|---|---|
| 可抓取 | 页面正文出现在HTML源码中 | 查看源代码搜正文 |
| 可摘录 | 小节独立成立、结论在首句 | 单独截出小节能否看懂 |
| 可核验 | 数据带来源与统计口径 | 逐条检查数字出处 |
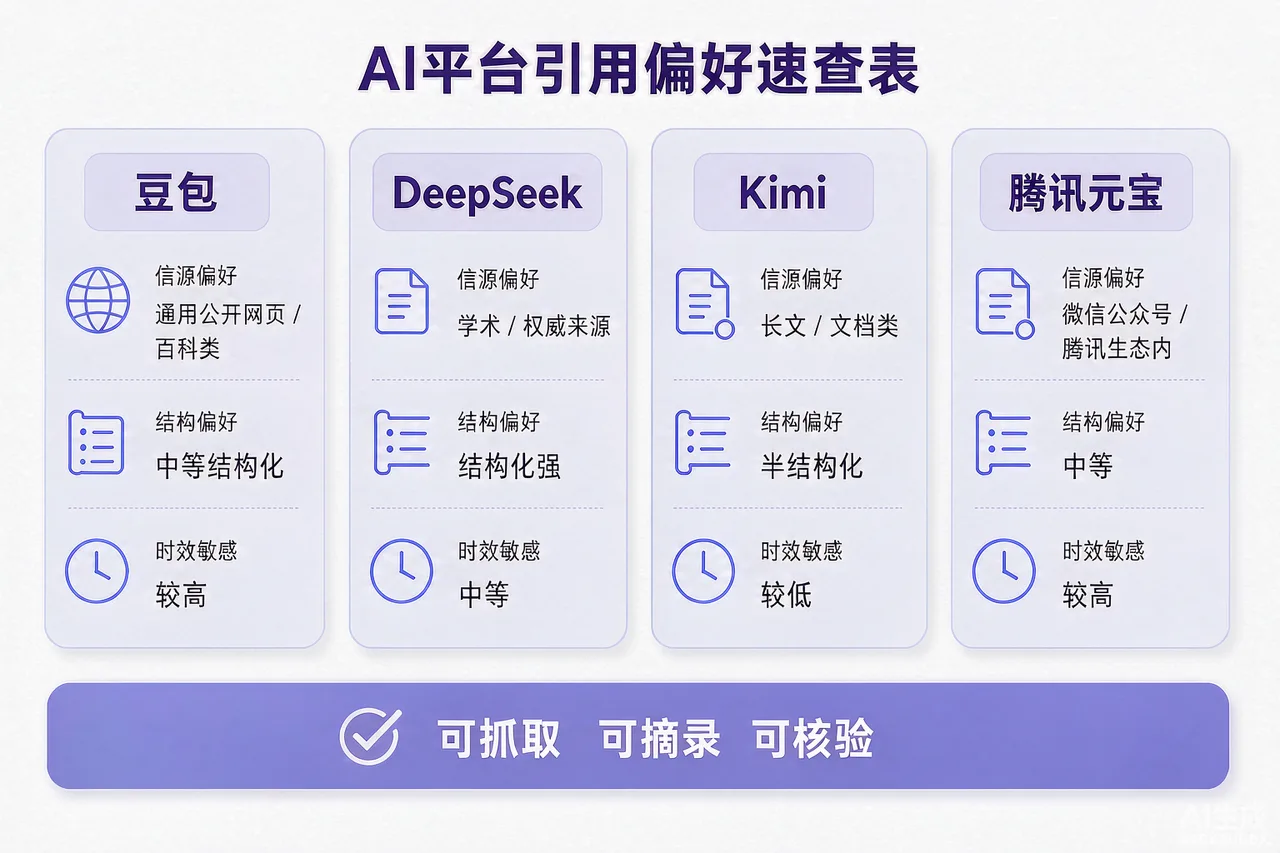
四个AI平台在信源偏好上确有差异,但三者共同的门槛是"内容可抓取、段落可摘录、来源可核验"。未满足这三点时,任何平台差异都无从发挥——内容根本没进入候选池,谈偏好没有意义。所以适配的第一优先级永远是把自己这一侧的基础做扎实。
四平台引用偏好速查表
四个平台在信源、结构、时效三个维度上确有差异,速查如下。
| 平台 | 信源偏好 | 结构偏好 | 时效敏感 | 适配动作 |
|---|---|---|---|---|
| 豆包 | 综合平台+本地生活类 | 口语化问答、清单 | 中 | 写口语问句小标题 |
| DeepSeek | 技术社区、长文、文档 | 方法论、步骤框架 | 中高 | 写步骤化框架文 |
| Kimi | 长文档、报告、学术 | 长文、引用完整 | 中 | 提供完整论证与来源 |
| 腾讯元宝 | 公众号、资讯、生态内容 | 图文、时新话题 | 高 | 公众号同步+时效标注 |
四平台的差异可以概括为一句话:豆包偏综合与本地生活,DeepSeek偏技术方法论,Kimi偏长篇与完整引用,元宝偏公众号生态与时新性。同一篇内容在这四个平台的被引用表现可能差别明显,因此"一份内容分发到四平台就能全覆盖"的想法通常不成立。
适配动作1:按平台写"内容变体"而非照搬
同一主题应按目标平台改写成不同变体,而不是四处复制同一篇。
做法:以一篇方法论内容为母版,针对豆包改出"口语问句版",针对DeepSeek保留"步骤框架版",针对Kimi扩写"论证完整版",针对元宝改出"资讯图文版"。多平台一致性方法与分发节奏可参考 多平台内容分发时怎么保持GEO一致性?;如何统计各平台的引用表现,可参考 AI引用率怎么统计?有没有工具?3种统计口径+零成本方法(2026版)。
适配动作2:优先在公众号与自有站双备份
微信公众号在腾讯生态内被取用的机会较多,值得作为重点渠道之一。
对本地商家而言,公众号既可用作自有信源,也可能被元宝一类生态内产品取用。做法:重要内容在自有站与公众号同步发布,保持标题与核心结论一致。
| 渠道 | 归属 | 主要作用 |
|---|---|---|
| 自有官网 | 自建 | 基准版本与内链枢纽 |
| 公众号 | 平台生态 | 生态内取用来源 |
| 第三方媒体 | 外部 | 交叉验证信源 |
| 问答平台 | 外部 | 长尾问句覆盖 |
适配动作3:建一张四平台自测记录表
平台偏好不能靠听说,要靠自己的测试数据。记录字段如下表。
| 记录字段 | 说明 |
|---|---|
| 问句 | 固定问句原文 |
| 平台 | 豆包/DeepSeek/Kimi/元宝 |
| 是否提及 | 有/无 |
| 提及位置 | 前段/中段/末尾 |
| 引用来源 | 抓取的URL |
| 记录日期 | 固定频率 |
平台偏好不能靠听说,要靠自己的测试数据。四个平台、同20个问句、每周一次,一个月后你就能看出自己的内容在哪个平台表现更好。这份自测数据比任何"平台偏好攻略"都更贴合你的实际情况——因为偏好会随平台迭代变化,只有你自己的记录是持续有效的。
常见误区
第一,把攻略当成固定结论。平台策略会迭代,速查表需定期重测。第二,四个平台发同一篇。不做变体,等于放弃适配。第三,只看"是否提及"。提及位置与引用来源同样重要。
FAQ
哪个平台对本地商家最友好? 从信源偏好看,综合平台与本地生活类内容在豆包与元宝上的表现通常更活跃,但具体仍应以自测结果为准。
需要每个平台都做吗? 起步阶段建议先做1-2个客户最常用的平台,做透再扩,避免精力分散。
这张表多久更新一次? 建议每季度重测一次。平台策略与信源偏好的变化频率通常快于这个周期。
没有公众号怎么办? 自有官网同样可作为基准信源,但建议至少开通一个生态内渠道,增加被取用的入口。